模型用量
打开 翻译统计 → 模型用量,查看近期调用了哪些 AI 服务和模型,以及请求次数、成功情况与 Token 用量。
查看翻译统计操作演示
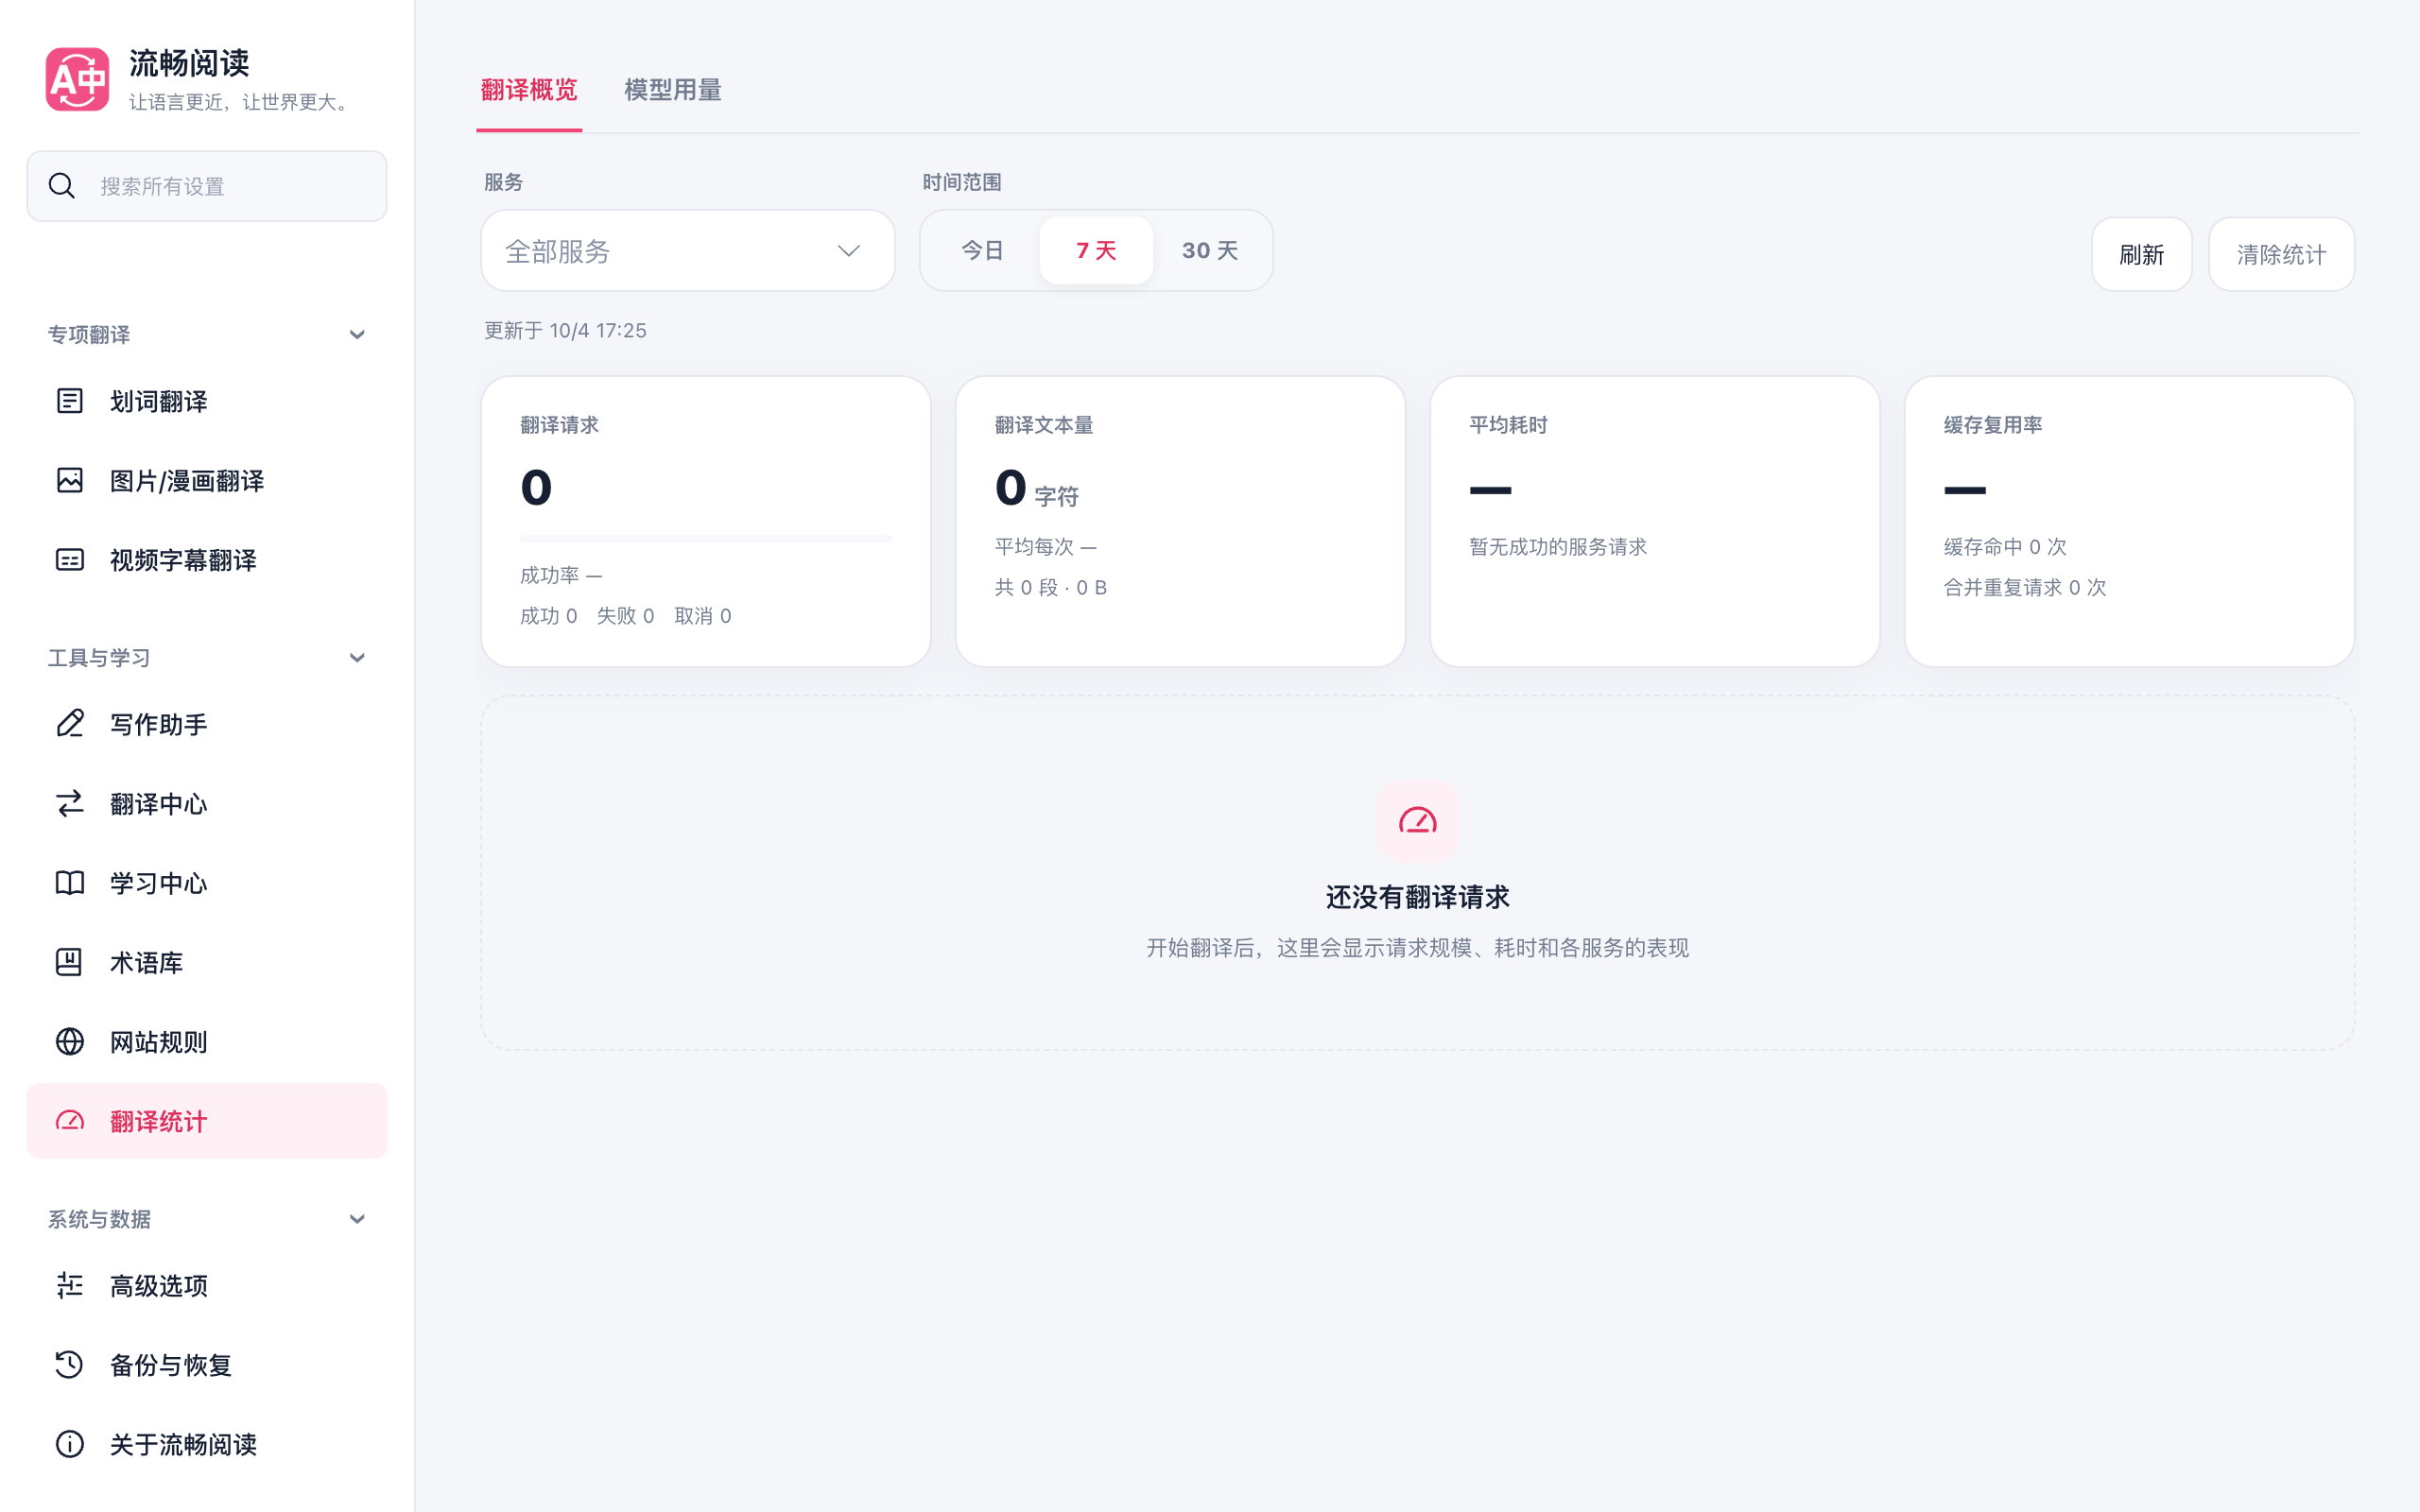
①点击翻译统计
真实扩展界面 · 点击图片查看大图
看一段时间的变化
选择时间范围,查看趋势。服务商返回明细时,还可以区分输入、输出以及缓存等用量;没有返回的数据会显示为缺失,不能当成精确账单。
模型列表帮助你找到常用服务,请求记录可用于检查失败与重试。需要核对费用时,以服务商后台账单为准。
管理记录
管理记录
用量记录保存在当前浏览器,可以按页面提供的操作导出或清除。它记录请求和用量信息,不作为全文翻译历史使用。清除记录不会撤销已经产生的服务费用。
想减少用量,可以只查需要的句子,或在不需要时关闭 AI 精翻。配置方法见翻译服务。
输出速度(token/s)按可计算成功请求的输出 Token 总和除以这些请求的总耗时(秒)计算,包含等待与传输时间,不是纯生成速度。缺失输出或有效耗时显示 —;零输出显示 0。概览展示平均速度与可计算请求数,请求明细展示单次速度。平均耗时仍包含全部调用。
请求记录默认展开,每条记录直接展示输出速度(token/s);服务与模型分布中的每一行也展示对应的平均输出速度。记录区常驻展示,可按场景、状态和缓存筛选,使用上一页、下一页或输入页码直接跳转。再次点击选中的服务或模型行可取消筛选。统计说明以浮层展示,“本机”提示可悬停查看保留范围;平均每次请求的构成默认可见。